
SQL Veritabanı
Bu ekran, tanımlı bir veri kaynağının içini gezip sorgu denemek içindir. Sorguyu kaydetmeden önce burada çalıştırır, sonucu görür, sonra SQL Sorgu olarak saklarsınız.
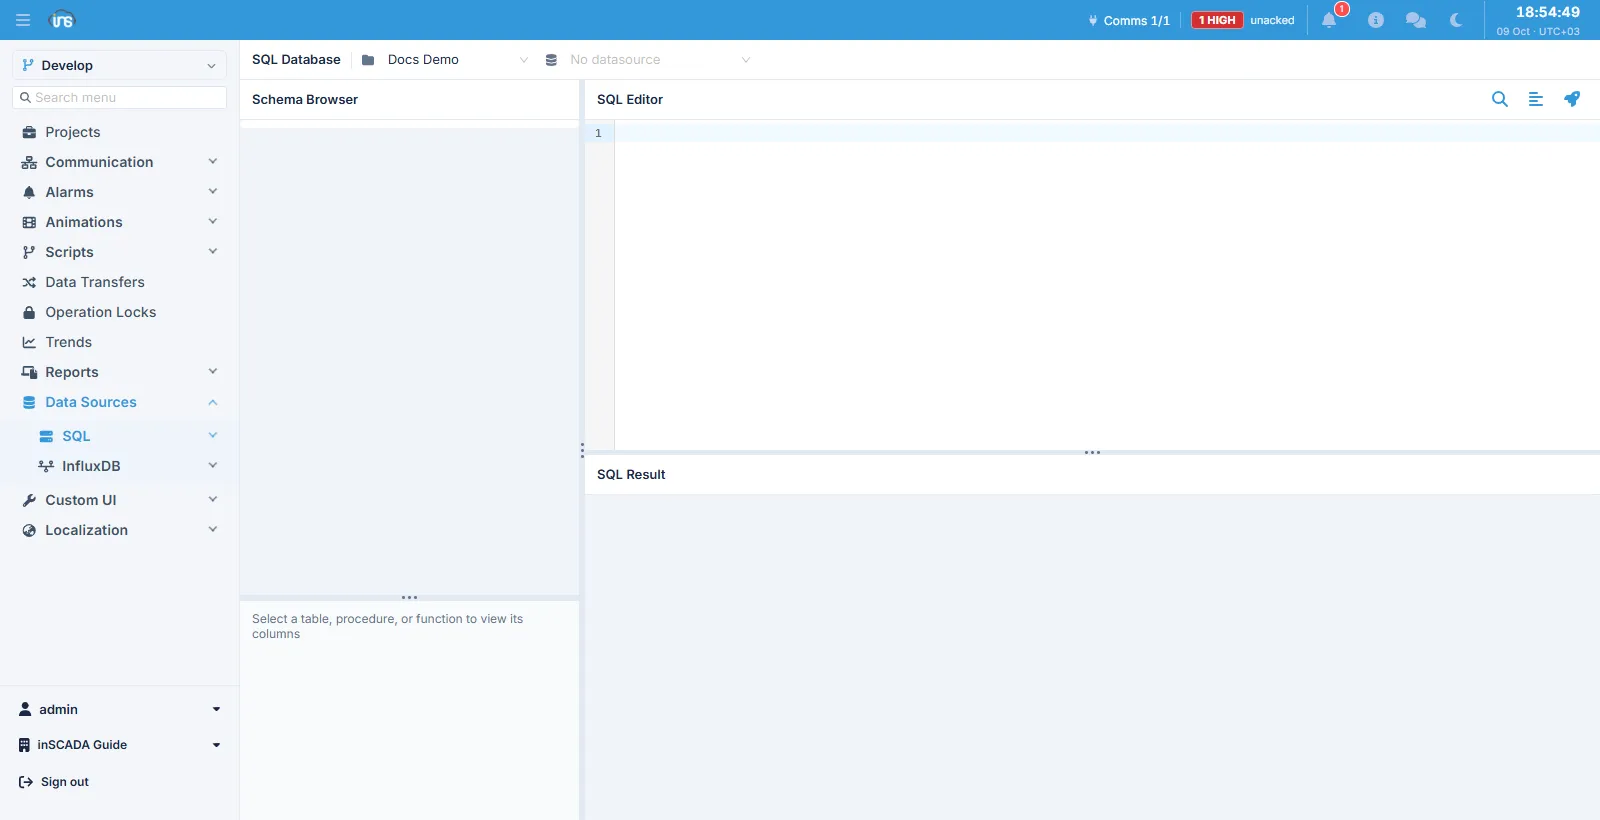
Üstte önce proje, sonra o projedeki veri kaynağı seçilir. Ekran üç bölümdür: solda şema tarayıcı, sağ üstte SQL editörü, sağ altta sonuç.
Şema tarayıcı
Section titled “Şema tarayıcı”Ağaç, veri kaynağının şemalarıyla başlar. Bir şemayı açtığınızda üç klasör gelir ve her birinin yanında kaç öğe olduğu yazar:
- Tables
- Procedures
- Functions
Bir tabloyu seçtiğinizde alttaki panelde kolonları, bir yordam ya da fonksiyonu seçtiğinizde parametreleri listelenir.
Hızlı sorgular
Section titled “Hızlı sorgular”Ağaçtaki bir tabloda sağ tık menüsü hazır sorgular sunar:
| Komut | Ne yapar |
|---|---|
| First 10 / 100 / 1000 rows | Tablodan ilk satırları getirir |
| Count rows | Satır sayısını verir |
| Open in editor | Sorguyu çalıştırmadan editöre yazar |
Bu sorgular, veri kaynağının JDBC adresinden anlaşılan lehçeye göre üretilir: adın nasıl tırnaklanacağı ve satırın nasıl sınırlanacağı veritabanına göre değişir. MySQL/MariaDB, SQL Server ve Oracle ayrı ayrı tanınır; geri kalanı (PostgreSQL, H2, SQLite, TimescaleDB ve benzerleri) standart biçimi kullanır.
Editör ve sonuç
Section titled “Editör ve sonuç”Editörde yazdığınız sorgu, seçili veri kaynağında çalışır ve sonuç alttaki panelde tablo olarak görünür. Bölümler arasındaki ayraçlar sürüklenebilir.
Burada çalıştırmak bir deneme değildir: sorgu gerçekten o veritabanında koşar. Üretim veritabanına bağlı bir kaynakta yazarken bunu aklınızda tutun.
Şema ağacını görmek VIEW_DB_METADATA, sorgu çalıştırmak RUN_QUERY yetkisi ister; ikisi ayrı yetkilerdir, yani bir kullanıcıya sorgu çalıştırmadan şemayı gezdirebilirsiniz.
İlgili
Section titled “İlgili”- SQL Veri Kaynağı — bağlantı tanımı ve zaman aşımları
- SQL Sorgu — sorguyu kaydetme
- InfluxDB Sorgu — zaman serisi tarafındaki editör